Gemini 4 arrasa en los benchmarks… y ahí está la trampa
Google vuelve a la carrera de la IA con Gemini 4 Argon: gana casi todas sus pruebas, pero sus propios empleados dudan de él al programar. Te lo contamos.
 Por Jorge Sánchez
0 comentarios
Google ha vuelto. Después de meses en los que parecía haberse quedado atrás frente a OpenAI y Anthropic, la compañía presentó el 30 de septiembre Gemini 4 Argon, su nuevo modelo de inteligencia artificial más potente. Y los números son espectaculares: según las pruebas de la propia Google, gana en la mayoría de los benchmarks a GPT-6 Astra, Claude Opus 5.5 y Claude Fable 5.1. El problema es precisamente ese: que son benchmarks.
Qué es Gemini 4 Argon
Argon es el nuevo modelo «frontera» de Google DeepMind, el que compite en la liga de los más avanzados del mundo. Google lo ha pensado para tareas largas y complejas: programación de verdad, trabajo profesional en derecho y finanzas, y ciberseguridad. Entre sus novedades técnicas destaca que puede generar respuestas de hasta 1 millón de tokens de una sola vez, frente a los 64.000 de los Gemini anteriores.
Eso sí, de momento casi nadie puede usarlo. Google lo está repartiendo por fases: primero a un grupo de expertos en ciberseguridad de confianza dentro de su programa Fairwind, y además participa en el proceso voluntario del Gobierno de EE. UU. para revisar los modelos antes de lanzarlos. Llegará después a los clientes de pago de la API y a los suscriptores de Google AI Ultra, pero sin fecha: Google solo dice «lo antes posible».
Las cifras: gana casi todo… en sus propias pruebas
En la tabla que ha publicado Google, Gemini 4 Argon queda primero en 13 de las 19 pruebas y empata en otra. Algunas diferencias son enormes, como en el benchmark legal de Harvey (19,6 % frente al 5,4 % de GPT-6 Astra) o en tareas de automatización (51,3 % frente al 42,5 % de Opus 5.5).
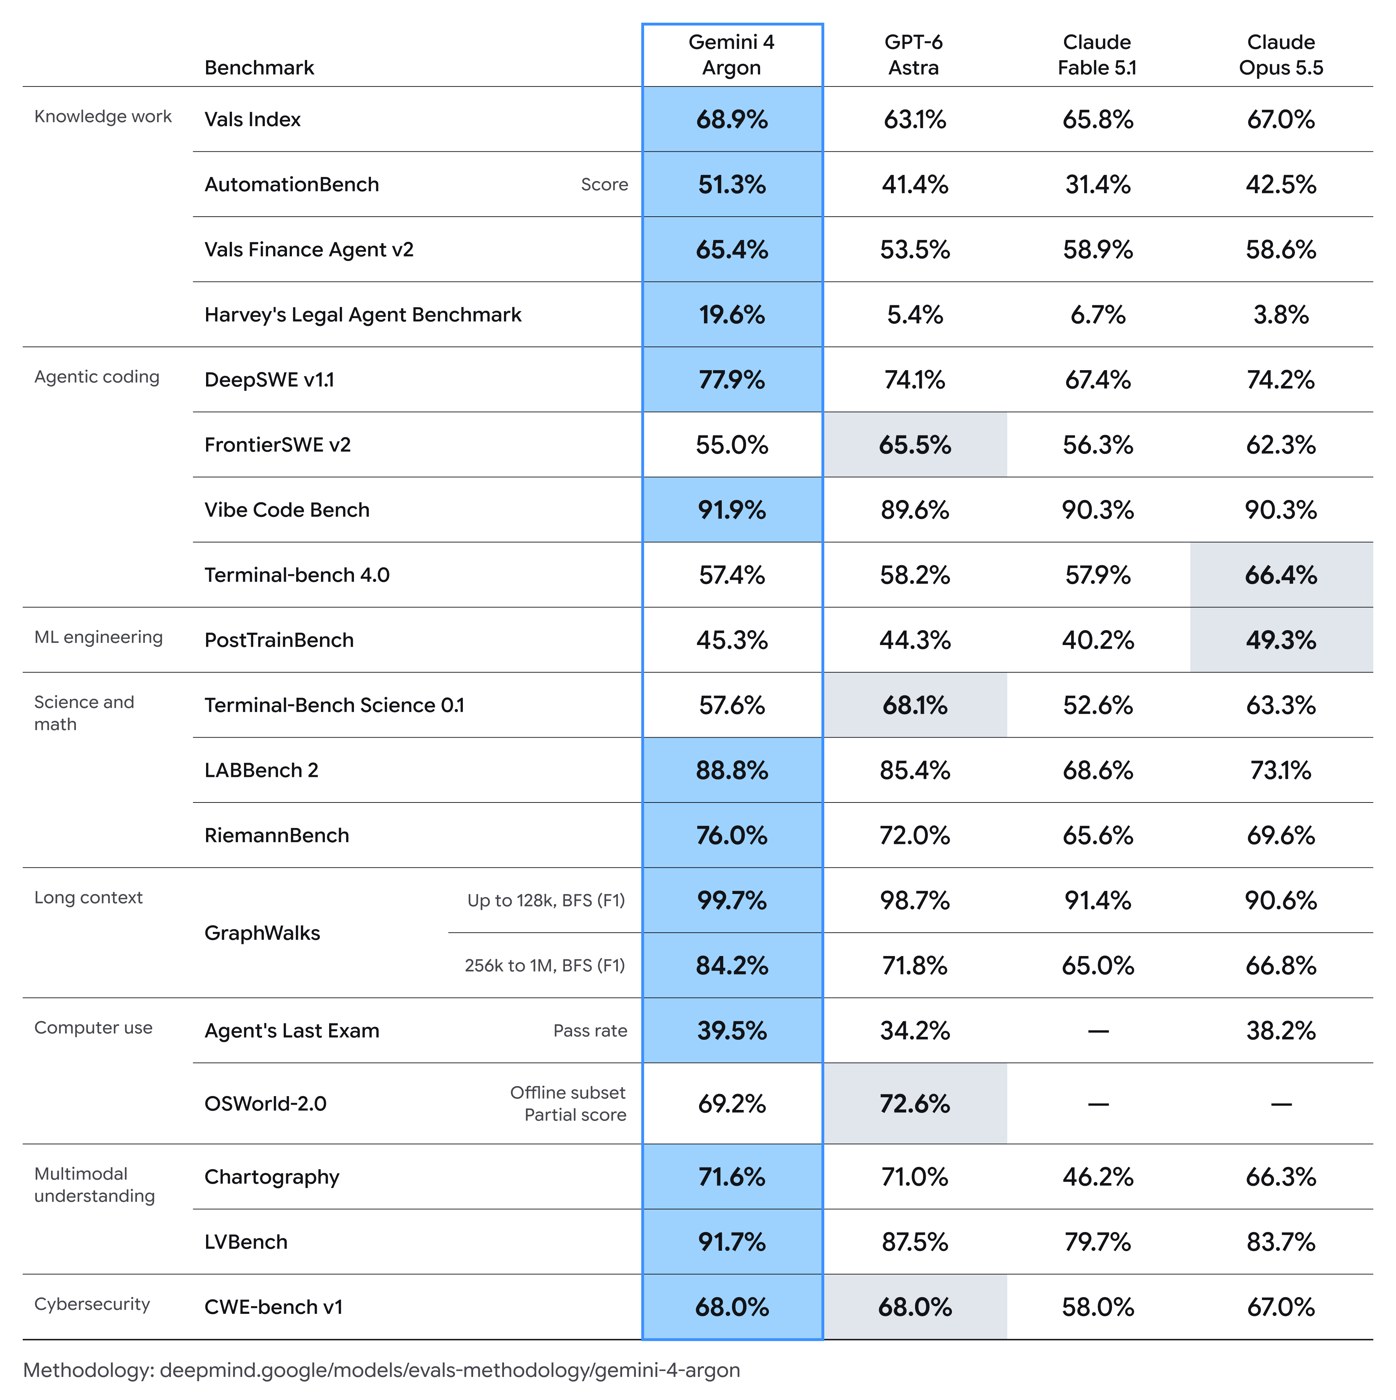
Pero la letra pequeña de la propia tabla es interesante. En programación agéntica, el terreno donde más se pelean ahora los modelos, Argon gana en DeepSWE y en Vibe Code Bench, pero pierde en FrontierSWE v2 (55 % frente al 65,5 % de GPT-6 Astra) y en Terminal-bench 4.0 (57,4 % frente al 66,4 % de Opus 5.5).
Las mediciones independientes también rebajan un poco la euforia. En el índice de inteligencia de Artificial Analysis, Gemini 4 Argon saca 53 puntos, empatado con GPT-6 Astra y con Claude Fable 5.1, pero por detrás de Claude Opus 5.5, que se va a 58. Es decir, Google vuelve a estar en el grupo de cabeza, pero no lo lidera.
Sus propios empleados no lo tienen tan claro
La parte más jugosa la ha contado Bloomberg. Varios empleados de Google que ya usan Argon aseguran que saca notas fantásticas en las pruebas, pero que cuando lo ponen a trabajar en ciertas tareas de programación no va tan fino. Según esas fuentes, flojea por ejemplo en el diseño de interfaces de webs y apps, y dos personas hablan directamente de benchmaxxing: concentrar el esfuerzo en sacar buena nota en los tests.
Google lo niega. Asegura que es «inexacto» decir que Gemini 4 rinde por debajo en programación y que hay «un amplio consenso» interno en que el modelo está en la frontera. Sundar Pichai, su consejero delegado, defiende que sus equipos lo usan a diario con buenos resultados. Dentro de la casa, como se ve, hay opiniones para todos los gustos.
Un benchmark es solo un benchmark
Aquí está el fondo del asunto. Una prueba de programación intenta parecerse a un trabajo real, pero tiene que ser una tarea cerrada, que se pueda comprobar y repetir siempre igual. El día a día no es así: proyectos enormes, código heredado, documentación a medias… Un modelo puede brillar en el examen y luego no convencer tanto en el trabajo de cada uno. Hasta que la gente pueda usarlo, no sabremos cuál de las dos versiones es la buena.
Menos «alucinaciones», con truco
Un dato que sí suena muy bien: según Artificial Analysis, Gemini 4 Argon tiene una tasa de alucinaciones (respuestas inventadas) del 15 %, la más baja entre los modelos punteros, frente al 51 % de GPT-6 Astra. Pero tiene su explicación: Argon se inventa menos porque prefiere responder «no lo sé». Es una forma muy sensata de comportarse, pero no significa que sepa más; en esa misma prueba, Astra acierta más preguntas.
Y en precio, Google aprieta
Para los desarrolladores, Google llega con un precio de lanzamiento de 2 dólares por millón de tokens de entrada y 10 por millón de salida. Según Artificial Analysis, con esos precios completar una tarea de su índice cuesta 1,99 dólares con Argon frente a 3,26 con GPT-6 Astra, aunque Argon gasta muchos más tokens para llegar al mismo sitio. Ojo: es un precio de introducción y Google ya ha avisado de que lo duplicará a 4 y 20 dólares más adelante.
¿Y a mí qué me cambia?
Hoy por hoy, nada: si usas Gemini en el móvil o en el navegador, todavía no tienes Argon, y cuando llegue lo hará primero para los planes de pago más caros. Lo importante es la foto general: con Google otra vez en primera línea, son tres gigantes peleando por tener la mejor IA, y esa competencia es la que acaba bajando precios y mejorando lo que usamos todos.
Fuentes: Xataka, blog oficial de Google, Artificial Analysis, The Decoder y Bloomberg.
Imágenes: Google.


0 comentario(s)